Bagaimana Cara Membuat Kecerdasan Buatan Memahami Ruang Nyata Hanya Bermodal Video Biasa?
Model kecerdasan buatan visual selama ini kerap gagal mengukur kedalaman fisik. Kerangka kerja baru VLM-IE3D membuktikan rekaman video biasa sudah cukup untuk melatih komputer mengenali ruang tiga dimensi layaknya mata manusia.
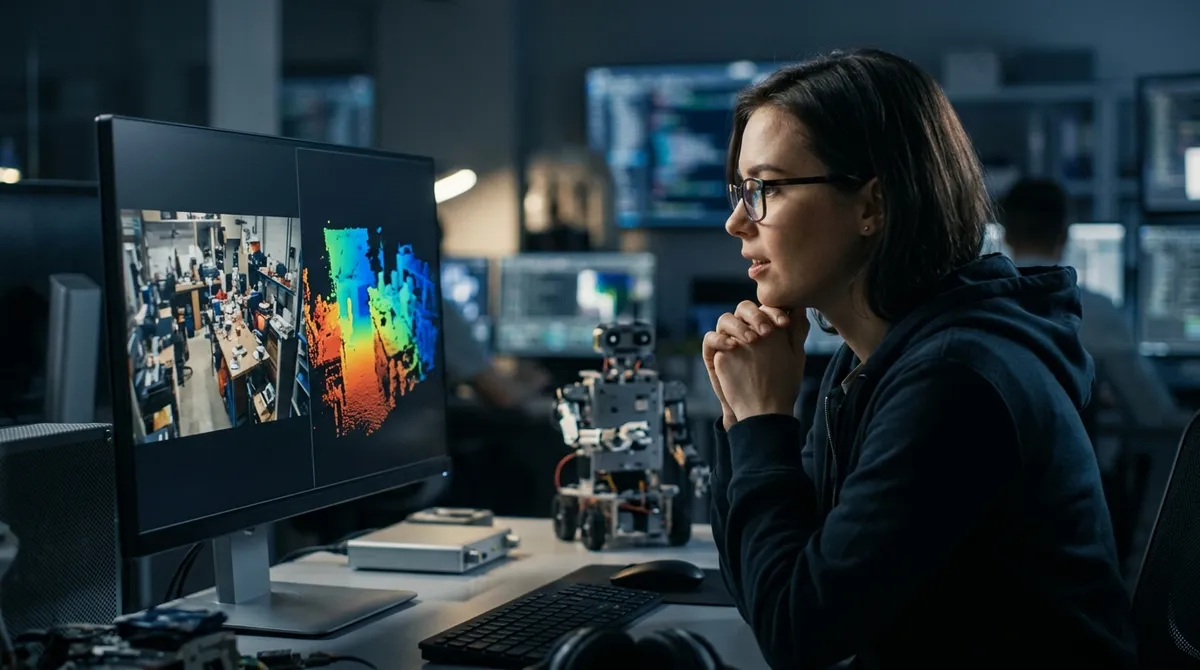
Mengapa sistem kecerdasan buatan yang sangat lihai mendeskripsikan foto sering kali gagal memperkirakan jarak di dunia nyata? Pertanyaan ini menjadi teka-teki besar ketika teknologi penglihatan komputer mulai diterapkan pada robot pelayan atau mobil otonom. Sebagian besar model bahasa visual masa kini hanya memproses rekaman layaknya lukisan datar dua dimensi. Mesin mengenali warna cangkir atau corak meja, tetapi buta terhadap jarak fisik yang memisahkan kedua benda tersebut. Akibatnya, lengan robotik masih kerap menyenggol gelas hingga tumpah saat mencoba mengambilnya.
Kelemahan mendasar tersebut kini menemukan jalan keluar yang menjanjikan. Tim peneliti gabungan yang dipimpin oleh Wenhao Li dari Nanyang Technological University menghadirkan kerangka kerja inovatif bernama VLM-IE3D. Sistem ini berhasil melatih kecerdasan buatan untuk membaca ruang tiga dimensi secara akurat hanya bermodal rekaman video standar. Riset yang diterbitkan di repositori ilmiah arXiv ini membuktikan lompatan baru dalam penglihatan mesin. Komputer kini dapat memahami kedalaman ruang tanpa perlu bantuan sensor pemindai berharga mahal.
Selama bertahun-tahun, industri teknologi mengandalkan sensor laser berbobot berat untuk memetakan ruangan. Pengembang biasanya menyematkan perangkat pemindai jarak khusus agar robot tidak menabrak dinding atau kaki meja. Langkah ini tidak hanya membuat ukuran perangkat menjadi bongsor, tetapi juga mendongkrak ongkos produksi secara signifikan. Jika kamera video biasa dipaksa membaca ruang tanpa alat bantu sensorik, perkiraan mesin kerap melenceng jauh. Rekaman kamera biasa memang hanya menyajikan bidang datar tanpa informasi kedalaman alami.
Wenhao Li dan timnya mengatasi rintangan tersebut dengan menggabungkan dua lapis kecerdasan geometri sekaligus. Kerangka VLM-IE3D memproses video biasa melalui dua jalur pemahaman yang saling melengkapi. Jalur pertama menangkap intuisi bentuk umum ruangan, seperti batas lantai dan pola pergerakan benda di sekitar. Sementara itu, jalur kedua menghitung detail ukuran dan batas fisik objek secara terperinci dari rekonstruksi visual. Keduanya kemudian disatukan oleh modul adaptor cerdas yang menyelaraskan data bentuk fisik dengan gambar aslinya.
Mekanisme kerja ini mirip seperti seorang penata panggung teater yang merancang pertunjukan langsung. Jalur pertama memberi gambaran luas mengenai batas panggung dan arah masuk para pemeran. Jalur kedua memastikan setiap properti meja dan kursi diletakkan pada posisi yang tepat tanpa saling bertubrukan. Lewat kombinasi ini, komputer dapat menyadari bahwa sebuah vas bunga berdiri kokoh di atas meja, bukan melayang di udara. "Kami melihat rekaman video biasa sebenarnya menyimpan informasi bentuk fisik yang sangat kaya jika diolah secara terarah," ujar Wenhao Li dalam penjelasan risetnya.
Dalam serangkaian pengujian di laboratorium, model VLM-IE3D mencatatkan lonjakan kemampuan yang sangat konsisten. Sistem ini membukukan akurasi hingga 68,5 persen saat mendeteksi objek dan menalar posisi benda dalam ruang bergerak. Catatan performa tersebut mengungguli berbagai model visual sebelumnya yang sering tersesat saat membaca lingkungan dinamis. Model ini juga mampu menjelaskan susunan ruangan dan mengenali perintah navigasi dengan ketepatan tinggi. Yang paling mengesankan, seluruh keunggulan komputasi ini tercapai murni mengandalkan video biasa tanpa berkas data tiga dimensi tambahan.
Dampak praktis dari penemuan ini sangat terasa bagi perkembangan teknologi ramah kantong. Di banyak negara berkembang seperti Indonesia, pengadaan sensor pemindai laser bernilai puluhan juta rupiah sering membebani anggaran periset lokal. Pengembang robotika pemula kerap kesulitan menciptakan purwarupa canggih akibat mahalnya komponen pemindai ruang. Ketika kamera ponsel atau webcam murah kini bisa disulap menjadi mata yang awas, biaya pembuatan robot asisten rumah tangga dapat ditekan drastis. Akses teknologi canggih pun kini semakin terbuka bagi khalayak yang lebih luas.
Kemampuan menalar ruang tiga dimensi menandai babak baru bagi interaksi mesin cerdas dengan manusia. Mobil tanpa pengemudi kini bisa membaca jarak trotoar dengan lebih luwes tanpa risiko salah perhitungan fatal. Kacamata pintar berbasis realitas tertambah juga dapat menampilkan informasi digital tepat di atas permukaan meja tanpa terlihat melenceng. Riset dari Nanyang Technological University ini membuktikan bahwa kecerdasan sejati komputer tidak cuma bertumpu pada kemampuannya merangkai kata. Masa depan teknologi berada di tangan mesin yang mampu memahami dan menghargai batas ruang fisik tempat kita hidup sehari-hari.
Komentar (0)
informasi Terkait
Banjir Informasi Digital, Riset Baru Dorong Literasi Visual Bagi Mahasiswa
Riset terbaru memetakan lonjakan studi literasi visual di kampus global, menyoroti tingginya produktivitas riset akademisi Indonesia sekaligus tantangan minimnya kolaborasi internasional.
Bisakah Buku Cerita Interaktif Menyelamatkan Periode Emas Anak dari Candu Layar?
Tim peneliti Universitas Negeri Malang merancang NUSA PLAY BOOK, media belajar interaktif berbasis kearifan lokal yang ampuh melatih motorik sekaligus mengurangi ketergantungan gawai pada anak usia dini.
Kerangka Riset Ilmiah Yang Mengubah Tebakan Pasar Menjadi Keputusan Terukur
Banyak calon manajer sempat mengambil keputusan penting bermodal firasat semata. Lewat kerangka metodologi bertahap, periset bisnis kini membedah dinamika pasar secara terukur dan presisi.
Jangan lewatkan informasi sains dan teknologi terbaru.
Dapatkan ringkasan informasi riset mingguan.